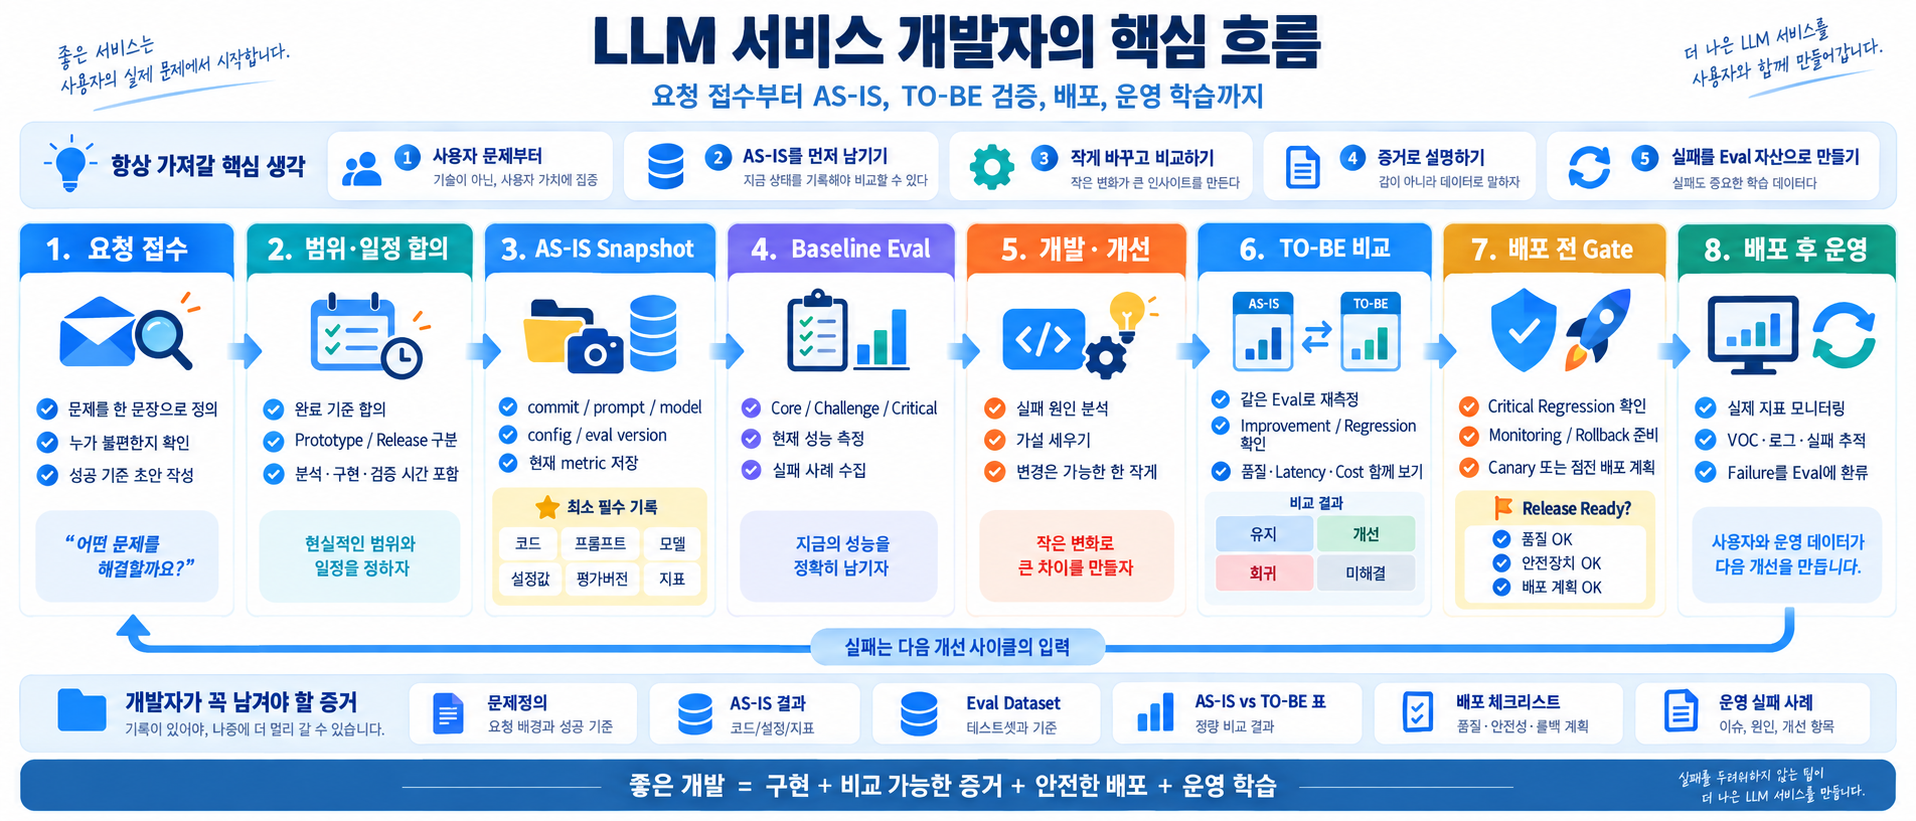
비교할 근거는 남기고,
대응은 위험에 맞춥니다.
모든 버그에 같은 검증량을 요구하지 않습니다. 지금 막아야 할 피해, 나중에 터질 위험, 단순 오류, 빠른 납기 요청을 구분합니다.
요청과 일정 협의부터 AS-IS·TO-BE, 배포, 긴급 예외의 사후 종료까지 이어지는 실무 플레이북입니다.
같은 원칙은 유지하되, 같은 순서를 강제하지 않습니다.
평시: 기준선 → 변경 → 비교 → 배포.
실제 피해가 진행 중인 때: 피해 차단·공유 → 최소 기록·확인 → 복구 → 정식 수정·평가.
“급하니 무검증”도, “원칙상 전체 평가가 먼저”도 정답이 아닙니다. [17] [19]
좁은 화면에서는 흐름도를 좌우로 넘겨 보세요.
문제·범위·일정·성공 기준을 합의합니다.
같은 입력과 채점 기준을 고정합니다.
AS-IS 버전과 사례별 원출력을 보관합니다.
TO-BE 버전과 같은 항목을 보관합니다.
개선·회귀·위험과 배포 결정을 남깁니다.
다섯 개의 새 문서를 만들라는 뜻은 아닙니다. 이슈 하나와 버전별 결과 폴더로 시작해도 됩니다. 평가·배포·운영을 연결하는 원칙은 공식 가이드에서 확인할 수 있으며, 이 문서의 파일 구성과 일정표는 그 원칙을 작은 팀에 맞게 재구성한 제안입니다. [1] [3] [4] [6]
읽는 기준: 공통 원칙 출처에서 확인한 방법 · 실무 제안 적용을 돕기 위한 구성 · 가상 예시 실제 측정값이나 업계 표준이 아닌 숫자. 모든 회사가 같은 절차를 쓴다는 의미는 아닙니다.
원문을 읽고, 해석을 구분하고, 적용합니다.
본문 곳곳의 인용 상자에서 짧은 영어 원문 → 한국어 번역 → 원문의 맥락 → 이 문서의 적용 → 적용의 한계를 확인할 수 있습니다. 번역은 비공식 번역입니다. 출처는 방법의 근거이지, 특정 일정이나 개선 효과를 보장하는 인증이 아닙니다.
평가는 개발 마지막에 붙이는 절차가 아닙니다.
Evaluate early and often. Write scoped tests at every stage.
한국어 번역초기부터 자주 평가하고, 단계마다 범위가 분명한 테스트를 작성하세요.
원문의 맥락OpenAI는 개발 초반부터 업무에 맞는 평가를 반복하고, 성공 목표·데이터·채점·비교·지속 평가를 연결하라고 권고합니다.
이 문서의 적용평시에는 첫 변경 전에 AS-IS와 성공 기준을 남깁니다. 다만 실제 피해의 긴급 차단을 전체 평가가 지연시키지 않도록 별도 대응 경로를 둡니다.
적용의 한계이 권고가 특정 평가 플랫폼의 도입이나 모든 변경에 대규모 평가를 요구하는 것은 아닙니다.
“얼마나 급한가”보다 먼저, “무슨 피해인가”를 묻습니다.
심각도, 시간 민감도, 처리 우선순위, 수정 자체의 위험을 구분하면 과잉 대응과 위험한 생략을 함께 줄일 수 있습니다.
망가지면 얼마나 큰 피해인가?
데이터 유출·잘못된 실행·주요 기능 중단·소수 사용자의 불편을 구분합니다. 현재 관측된 피해와 조건이 맞으면 생길 잠재 피해를 따로 씁니다.
다른 작업보다 언제 먼저 처리할까?
피해의 크기와 발생 시점, 노출 범위, 업무 마감, 가용 인력을 함께 반영한 처리 결정입니다. 요청자의 직급 자체가 기술적 심각도를 바꾸지는 않습니다.
심각도와 우선순위가 항상 같은 것은 아닙니다.
Severity is a measurement of impact.
한국어 번역심각도는 영향의 정도를 측정합니다.
원문의 맥락Atlassian은 영향과 처리 긴급도를 구분합니다. 낮은 심각도의 문제도 업무상 높은 우선순위를 가질 수 있다고 설명합니다.
이 문서의 적용임원 시연의 오타는 빠르게 처리할 수 있어도, 데이터 유출과 같은 긴급 배포 절차를 자동 적용하지는 않습니다.
적용의 한계업무 마감과 계약 영향도 실제 위험의 일부입니다. 마감 요청을 무조건 무시하라는 뜻이 아니며, SEV·P0 명칭은 조직 기준을 따릅니다.
| 질문 | LLM 서비스에서 확인할 증거 | 일정에 미치는 영향 |
|---|---|---|
| 1. 피해가 지금 발생하는가? | 권한 밖 문서 노출, 발송·예약 오실행, 오류 증가, 반복 호출 비용 | 중대한 피해가 진행 중이면 먼저 차단·완화합니다. |
| 2. 언제 피해가 시작·확대되는가? | 다음 배치, 이벤트 만료, 캐시 TTL, 모델 종료, 용량 한계 | 최초 피해 가능 시점에서 검증·복구 시간을 역산합니다. |
| 3. 무엇까지 영향을 받는가? | 한 화면 / 공통 프롬프트 / 전체 인덱스 / 여러 테넌트 | 같은 한 줄 수정이라도 공유 범위가 넓으면 검증을 넓힙니다. |
| 4. 차단·복구할 수 있는가? | 기능 OFF, 읽기 전용, 승인된 대체 경로, 재처리·보상 절차 | 코드 수정 전에 더 빠르고 안전한 완화 수단을 검토합니다. |
| 5. 모르는 것은 무엇인가? | 영향 미확인, 재현 불가, 로그 누락, 롤백 호환성 미확인 | “문제없음”이 아니라 “미확인”으로 기록하고 조사·재분류합니다. |
확인에 드는 시간이 피해를 더 키운다면 더 작은 차단부터 선택합니다. 반대로 즉시 피해가 없는데 공유 모델을 서둘러 교체하면 변경 위험을 키울 수 있습니다. 이 비교는 기계적인 점수 공식이 아니라, 영향·불확실성·대안의 근거를 드러내는 판단입니다.
업무 영향과 시간 민감도를 함께 평가하고, 모든 사건을 동일하게 긴급 취급하지 않는 원칙을 참고했습니다. 위 질문과 아래 네 경로는 작은 LLM 서비스 팀을 위한 재구성이지 공통 산업 등급표는 아닙니다. [15] [16]
대응은 네 경로로 나눠 생각합니다.
피해 차단 우선
중대한 피해가 진행 중이거나 발생이 임박하고 노출을 줄일 필요가 있습니다.
일정의 첫 목표원인 규명보다 안전한 완화와 다음 상태 공유.
차단 후 정식 수정 →시한부 예방
지금은 정상이어도 배치·만료·누적·종료 조건에서 피해가 예상됩니다.
일정의 첫 목표최초 피해 이전에 안전 상태 확보. 촉박해지면 A로 전환.
피해 시점에서 역산 →일반 개선
검색·생성 품질 개선이나 영향 범위가 넓은 변경입니다. 확인할 가설이 있습니다.
일정의 첫 목표AS-IS → 최소 변경 → TO-BE 비교와 배포 판단.
기존 표준 흐름 →저위험 신속 수정
동작 경계가 좁고 재현 가능하며, 원인이 분명하고 쉽게 되돌릴 수 있습니다.
일정의 첫 목표재현 테스트 + 관련 회귀 + 배포 확인을 짧게 수행.
큰 Eval이 필요한가? →업무 우선순위를 높일 근거와 대신 미룰 일을 합의합니다. 기술적 위험에 맞는 경로와 배포 조건은 따로 유지합니다. 반대로 사소해 보이는 날짜 조건 하나라도 대량 오노출·오삭제를 만들면 저위험 경로가 아닙니다.
차단 완료, 수정 완료, 검증 완료를 따로 보고합니다.
피해를 멈추는 조치와 근본 원인을 고치는 변경은 다를 수 있습니다. “해결됐습니다”라는 한 문장으로 세 상태를 합치지 않습니다.
일반 변경 경로
C는 품질·회귀 비교, D는 결함의 재현·해소와 영향 범위 중심으로 검증합니다.
긴급 차단 경로
정식 수정은 원인을 분석한 뒤 일반 변경 흐름으로 연결합니다. 차단도 변경이므로 권한과 부작용을 확인합니다.
장애 중에는 피해를 멈추면서 증거를 보존합니다.
Stop the bleeding, restore service, and preserve the evidence for root-causing.
한국어 번역피해 확산을 막고, 서비스를 복구하며, 원인 분석을 위한 증거를 보존하세요.
원문의 맥락Google SRE의 사건 대응 지침은 즉흥적인 개별 수정 대신 조율된 대응과 실시간 기록을 강조합니다.
이 문서의 적용LLM 누출·오실행은 원인 분석이나 전체 Eval을 기다리지 않고 승인된 차단을 우선합니다. 시각·버전·조치·결과는 가능한 즉시 남깁니다.
적용의 한계증거를 모으느라 피해를 지속시키거나, 반대로 차단하면서 필요한 증거를 무조건 삭제하라는 뜻이 아닙니다. 조치의 부작용도 검토합니다.
| 경로 | 개발·조치 전 최소 기록 | 배포·변경 전 우선 확인 | 후속으로 남길 것 |
|---|---|---|---|
| A · 피해 차단 | 사건 ID, 영향·시각, 버전, 조치자, 안전하게 보존 가능한 증거 | 차단 대상·권한·대체 경로의 안전, 실행 중 작업, 조치의 부작용. 문서·전체 Eval 대기가 차단을 지연시키지 않음 | 차단 효과, 정식 수정 run, 미룬 검증·승인·기한, 영향 정정 |
| B · 시한부 예방 | 발생 조건·최초 피해 시각, 시간대, 데이터·배치·의존성 버전 | 경계·만료·누적·재실행 테스트, 마감 실패 시 예방 차단, 남은 복구 여유 | 실제 조건 통과 결과, 관찰 범위·주기, 임시 조치 해제 |
| C · 일반 개선 | 작업카드, 평가·채점 버전, AS-IS manifest와 원출력 | 동일 조건 TO-BE, 관련 회귀·품질·비용·지연·안전 | 배포 판단과 운영 성과, 새로운 실패의 평가셋 반영 |
| D · 신속 수정 | 이슈·commit·재현 사례·기대 결과·영향 범위 | 재현 실패→성공, 인접 경계·관련 통합, 공통 배포 검사와 복구 | 해소 증거·운영 확인, 해당 없음 항목의 사유 |
A의 조치 순서는 사건 대응 지침을, 긴급 검증의 후속 수행은 Microsoft의 Emergency SDP protocols를 참고했습니다. D는 검증 면제가 아니라 더 좁은 검증 범위를 선택하는 경로입니다. [17] [18] [19] [23]
LLM 서비스의 여섯 가지 실제형 시나리오
모두 설명을 위한 가상 사례입니다. 버튼은 예시를 전환할 뿐 심각도나 배포 승인을 자동 판단하지 않습니다.
다른 사용자의 문서가 답변에 섞인다
먼저 할 일승인된 절차로 문제 검색 경로를 제한하고, 안전한 범위만 제공하거나 기능을 중단합니다. 보안·운영 담당에게 즉시 공유합니다.
최소 AS-IS 기록사건 ID, 발견 시각, 현재 버전, 마스킹한 trace ID, 적용한 차단 조치를 남깁니다. 재현을 위해 실제 고객 데이터를 반복 노출하지 않습니다.
검증의 핵심분리된 검증 환경에서 테넌트·권한 경계, 캐시 키, 검색 필터, 인용 원문 접근을 확인합니다. 알려진 유출 경로가 막혔는지 먼저 검사합니다.
무엇을 보고 종료할까?영향 범위 조사를 계속하고, 격리 해제 전 관련 권한 회귀를 검증합니다. 필요 통지와 대응은 담당 보안 절차를 따릅니다.
전체 품질 Eval을 기다리는 동안 노출을 방치하거나, “출력하지 마”라는 프롬프트만 바꾸고 권한 검사를 대신합니다.
재시도 때문에 예약·발송이 중복 실행된다
먼저 할 일중복 쓰기 경로와 신규 실행을 차단하거나 승인된 수동 처리로 전환합니다. 이미 대기·실행 중인 작업도 확인합니다.
최소 AS-IS 기록업무 ID, 도구 요청 ID, 재시도 횟수, 성공·실패와 실제 상태를 보존합니다. 민감한 인자 원본은 보호 저장소에 제한합니다.
검증의 핵심모의 도구에서 타임아웃 후 성공, 응답 유실, 같은 요청 재전송을 테스트합니다. 멱등성과 최종 상태를 확인하며 문구만 검사하지 않습니다.
무엇을 보고 종료할까?신규 중복이 멈췄는지와 기존 중복의 정정·보상 상태를 따로 닫습니다. 패치 후 회귀 사례로 유지합니다.
코드 롤백을 했으니 이미 발송된 메시지나 예약도 취소됐다고 판단하거나, 실제 쓰기 요청으로 AS-IS·TO-BE를 동시에 재생합니다.
다음 배치부터 만료 이벤트가 계속 노출된다
먼저 할 일최초 영향 시각과 유예 가능 여부를 확인합니다. 고칠 시간이 부족하면 해당 배치·노출만 안전하게 제한하는 대안을 먼저 정합니다.
최소 AS-IS 기록원천 데이터 시점, 기준 시간대, 유효기간 조건, 배치 버전, 캐시 상태와 예상 영향 대상을 기록합니다.
검증의 핵심테스트 시계를 주입해 만료 직전·정각·직후, 캐시 만료, 배치 지연·재실행을 확인합니다. 운영 서버 시계를 임의로 바꾸지 않습니다.
무엇을 보고 종료할까?실제 경계 시점을 지나 데이터·캐시·검색 결과를 확인합니다. 경계 이전에 에러가 없다는 이유로 종료하지 않습니다.
“지금 잘돼요”라며 미루거나, 배치 일시 정지의 데이터 신선도 저하를 알리지 않고 무기한 방치합니다.
LLM 출력 후 화면에서 줄바꿈만 깨진다
먼저 할 일문제가 표시 계층에만 한정되는지 확인합니다. 프롬프트·파서·도구 인자에 영향을 주지 않는다면 좁은 변경으로 고칩니다.
최소 AS-IS 기록기존 commit, 문제 입력·출력, 실패 화면과 기대 표시를 남깁니다. 이번 품질과 무관한 비용 측정은 비대상 사유를 기록할 수 있습니다.
검증의 핵심표시 함수 테스트와 대표 화면·접근성·관련 통합 테스트, 배포 후 화면 확인을 수행합니다. 조직의 공통 배포 검사는 유지합니다.
무엇을 보고 종료할까?수정된 화면과 인접 기능을 확인하고 재현 테스트를 남깁니다. 수정이 공통 파서에 번지면 C로 재분류합니다.
모든 변경마다 대규모 LLM Judge를 실행하거나, 반대로 “한 줄 수정”이라며 영향 분석도 하지 않습니다.
내일 시연 때문에 답변을 빨리 바꿔 달라고 한다
먼저 할 일시연용인지 실제 사용자 배포인지 확인하고, 바뀌는 요구와 미룰 작업을 합의합니다. 운영 쓰기 없이 제한된 환경에서 시연하는 대안을 둡니다.
최소 AS-IS 기록요청 이유, 필요한 최소 범위, 제외 범위, AS-IS 결과, 납품 상태와 승인자를 기록합니다.
검증의 핵심표시 변경이면 관련 테스트, 공통 프롬프트 변경이면 핵심·위험 유형의 Eval을 수행합니다. 마감 압박 자체는 무검증 운영 배포 근거가 아닙니다.
무엇을 보고 종료할까?시연 완료와 운영 배포 준비를 별도로 보고합니다. 남은 검증과 시연용 임시 설정의 제거 담당·기한을 정합니다.
낮은 심각도에 P0라는 라벨을 붙여 전 팀을 중단시키거나, 데모 성공을 운영 검증 완료로 보고합니다.
일부 요청만 실패하지만 로그가 부족하다
먼저 할 일영향과 중대 가능성을 먼저 확인합니다. 피해가 의심되면 노출을 제한하고 담당자를 연결하며, 무조건 모델부터 바꾸지 않습니다.
최소 AS-IS 기록발생 시각, 요청 유형, 응답 코드, 버전, provider 상태, rate limit·timeout·재시도 지표를 최소 수집합니다.
검증의 핵심안전하게 샘플링한 trace와 합성 점검으로 재현합니다. fallback은 권한·데이터 처리·품질이 검증된 경로만 사용합니다.
무엇을 보고 종료할까?새로 확인한 사실·영향·다음 확인 시점을 공유합니다. 로그 부재만으로 해결 처리하지 않고 관찰·종료 조건을 명시합니다.
“재현 안 됨”을 “문제없음”으로 바꾸거나, 외부 장애를 무제한 재시도해서 비용·부하를 확대합니다.
“언젠가 터질 버그”는 마지막 착수 시각을 계산합니다.
첫 피해 가능 시점을 2026-09-24 02:00 KST 배치로 가정합니다. 순차 작업에 구현 3시간, 검증 1시간, 승인 대기 2시간, 배포 1시간, 복구 여유 2시간이 필요하다면 총 9시간입니다.
09-24 02:00 − 9시간 = 09-23 17:00 KST
이 시각은 권장 시작일이 아니라, 지연 없이 진행해도 빠듯한 마지막 경계입니다. 배포 창구와 담당자 근무 시간, 병렬 작업·선후관계, 추정 오차를 반영해 더 일찍 시작합니다. 남은 여유가 줄면 수정만 고집하지 말고 예방 차단·일정 재협의로 전환합니다.
고정 시점 위험
정책 시행·이벤트 만료·API 종료·인증서 만료. 기준 시각과 시간대를 기록하고 전·정각·후를 검사합니다.
누적형 위험
메모리 누수·재시도 비용·대기열 적체. 증가율과 잔여 여유를 추정하고 악화 시점을 계속 재평가합니다. 한 번의 정상 응답으로 검증하지 않습니다.
종료 공지가 있는 외부 모델·API는 종료 이후 예전 버전으로 돌아갈 수 없을 수 있습니다. 제공자의 공지에서 영향 시점을 확인하고, 검증된 대체 경로나 안전한 기능 중단을 복구 계획에 포함합니다. [21] 위 역산표와 테스트 방법은 이 문서의 실무 예시입니다.
“얼마나 고쳤나”가 아니라 “무엇에 영향을 주나”로 검증량을 정합니다.
| 바뀌는 대상 | 최소한 놓치지 않을 검증 | 평가를 넓힐 신호 |
|---|---|---|
| 화면 표시·단일 함수 | 재현 테스트, 경계 입력, 관련 화면·API | 공통 파서·프롬프트·보안 처리에 영향 |
| 공통 프롬프트·모델 | 주요 의도·금지 행동·핵심 회귀·응답시간·비용 | 전체 사용자·도구 선택·안전 정책의 동작 변화 |
| 검색·청크·원문 적재 | 검색과 답변, 권한·유효기간·삭제·중복·데이터 기준 | 공유 인덱스·여러 테넌트·재적재·캐시 영향 |
| 도구 스키마·재시도·권한 | 실제 최종 상태, 인자·인가·멱등성·실패 후 재실행 | 비가역 쓰기·개인정보·오발송·다중 단계 실행 |
| 시간·배치·누적 동작 | 시각 경계, 지연·반복 실행, TTL·관찰 기간 | 실제 조건을 아직 통과하지 않았거나 관측량 부족 |
여러 테스트 계층을 균형 있게 쓰는 관점은 Test Pyramid를 참고했습니다. 위의 LLM 변경별 조합은 실무 제안이며, 회사의 필수 CI 검사를 임의로 생략하라는 뜻이 아닙니다. [23]
버그를 고친 뒤에는 다시 잡을 수 있는 검사를 남깁니다.
No programming episode is complete without working code and the tests to keep it working.
한국어 번역작동하는 코드와 그 작동을 유지할 테스트가 함께 있어야 프로그래밍 작업이 끝납니다.
원문의 맥락Martin Fowler는 기능과 자동 테스트를 함께 관리하고, 생산 환경의 버그를 테스트의 빈틈을 찾는 계기로 삼는 관점을 설명합니다.
이 문서의 적용표시 오류는 표시 테스트로, 도구 중복은 멱등성 테스트로, 의미적 품질은 Eval로 남깁니다. 모든 버그를 대규모 LLM 평가 하나로 해결하려 하지 않습니다.
적용의 한계긴급 차단 이전에 반드시 새 테스트를 완성하라는 요구가 아닙니다. 피해를 멈춘 뒤 정식 수정과 재발 검증을 완료하는 원칙으로 적용합니다.
일정은 “언제 코딩이 끝나는가”가 아닙니다.
먼저 무엇을 납품할지 합의합니다. 데모, 검증된 후보, 운영 배포는 서로 다른 상태입니다.
A는 피해 완화와 다음 상황 공유부터, B는 최초 피해 시점에서 역산해, D는 좁은 재현·관련 검사 중심으로 산정합니다. 압박이 있다고 개선 효과나 복구 완료 시각을 근거 없이 확약하지 않습니다. 경로별 비교 보기 →
“카드 검색 좀 개선해주세요.”
이 문장만으로는 고칠 위치도, 검증 범위도, 종료 시점도 정해지지 않습니다.
“혜택 조건 검색의 누락을 줄입니다.”
이번에는 검색 표현만 개선합니다. 상품명 검색은 보존하고, 모델 교체·UI 개편·전체 공통화는 제외합니다.
평가 목표와 업무별 성공 기준을 먼저 정의하는 것은 eval 설계의 출발점입니다. [1] 아래 합의 방식은 실무 제안입니다.
| 항목 | 실제로 적을 내용 | 판단 책임 |
|---|---|---|
| 해결할 문제 | 누구의 어떤 요청이 실패하는지, 재현 사례와 업무 영향 | BA·요청자 + 개발자 |
| 포함 / 제외 범위 | 이번 변경 대상과 하지 않을 일. 기존 진행 업무의 우선순위 조정 | 요청자·팀 책임자 |
| 완료와 성공 기준 | 기능·품질·응답시간·안전 조건. 평가 미달 시에도 결과 보고로 종료할지 여부 | 도메인 담당 + 개발자 + 승인권자 |
| 일정과 변동 조건 | 실제 투입 가능 시간, 연계·승인 대기, 재산정 시점, 배포 가능 시간대 | 개발자가 산정 근거 제시, 관계자가 합의 |
접근법을 보여줍니다.
샘플 입력으로 가능성을 확인합니다. 운영 트래픽이나 실제 쓰기 권한을 주는 단계가 아닙니다.
변화량을 설명합니다.
고정 평가셋의 전후 결과, 회귀 사례, 비용·지연시간을 제출합니다. 개선 목표 미달도 유효한 결론입니다.
실패해도 대응합니다.
필수 안전 검증, 승인, 감지·중단·복구 방법이 준비된 상태입니다. 데모 완료와 혼용하지 않습니다.
일정 협의에는 개발자의 작업량 산정 근거가 필요합니다.
The Developers who will be doing the work are responsible for the sizing.
한국어 번역실제 작업을 수행할 개발자가 작업 규모 산정을 책임집니다.
원문의 맥락Scrum Guide는 작업 규모 산정의 책임을 실제 개발자에게 둡니다. 계획할 때 과거 수행 결과, 투입 가능 역량, 완료 기준을 고려하고 일을 작게 나누도록 설명합니다.
이 문서의 적용“4일 걸립니다” 대신 분석·기준선 확보·구현·검증·배포 준비의 작업량과 가정을 제시합니다. 일정은 관계자가 범위·우선순위와 함께 합의합니다.
적용의 한계sizing은 작업 규모 산정입니다. 달력 날짜를 혼자 확정한다는 뜻도, 아래 4인일 표가 Scrum 표준이라는 뜻도 아닙니다.
원인을 모르면, 조사와 구현의 견적을 나눕니다.
먼저 제한된 조사에서 재현·실패 유형·수정 범위를 확인한 뒤 일정을 다시 산정합니다. 원인도 모르는 상태에서 “4일이면 정확도가 6%p 오릅니다”처럼 성과를 약속하지 않습니다. 일정의 약속과 개선 효과의 가설은 별개입니다.
| 작업 | 끝났다는 증거 | 투입 공수 |
|---|---|---|
| 문제 재현·범위·성공 기준 합의 | 작업카드와 실패 사례 | 0.5인일 |
| 평가 보완·AS-IS 실행 | 고정 평가 버전, 기준선 원출력 | 0.5인일 |
| 가설에 맞춘 최소 변경 | 분리 가능한 코드·설정 변경 | 1.0인일 |
| TO-BE 실행·비교 | 사례별 변화와 지표표 | 0.5인일 |
| 회귀 분석·후보 조정 | 회귀 처리와 잔여 위험 기록 | 0.5인일 |
| 배포 준비·보고 | 배포 판단, 복구·관찰 계획 | 0.5인일 |
| 확인된 위험에 대한 여유 | 재적재·재실행 등 예상 변동 대응 | 0.5인일 |
| 예시 공수 합계 · 배포 승인 대기와 이후 운영 관찰은 별도 | 4.0인일 | |
회의·다른 업무로 하루 절반만 투입하면 작업일은 달라집니다. 보안 승인, 데이터 접근, 배포 창구의 대기는 중첩 여부와 선후관계를 반영해야 합니다. 평가셋이나 원천 데이터가 없으면 위 견적을 그대로 사용하지 않습니다.
“기존 평가 환경이 있다는 가정에서, 비교 결과와 배포 준비까지 약 4인일로 산정했습니다. 먼저 원인을 확인하고 수정 범위를 확정하겠습니다. 오늘 필요한 것은 샘플 시연인지 운영 배포인지 구분해 주세요. 일정이 고정이면 이번에는 혜택 검색만 개선하고 모델 교체는 제외하겠습니다. 운영 배포의 필수 안전 검증은 유지하겠습니다.”기간 숫자는 예시입니다. 실제 대화에서는 확인한 작업량과 가정을 바꿔 사용합니다.
마감이 고정이라면, 바꿀 수 있는 범위를 협의합니다.
Fixed time, variable scope
한국어 번역시간은 고정하고, 범위는 조정합니다.
원문의 맥락Basecamp는 투입할 시간 예산(appetite)과 필요한 작업량의 추정(estimate)을 구분합니다. 고정된 시간 안에서 핵심과 부가 기능을 선택하는 방식입니다.
이 문서의 적용“오늘은 혜택 검색만 개선하고 모델 교체는 제외한다”처럼 범위를 명시합니다. 데모와 운영 배포를 나누되, 운영의 필수 안전 검증을 조용히 빼지 않습니다.
적용의 한계Basecamp의 방법론을 일정 협의에 참고한 것입니다. 모든 회사가 고정 기간이나 같은 개발 주기를 쓴다는 근거는 아닙니다.
“아직 개발 중” 대신 “원천 데이터 누락을 확인했습니다. 검색 코드만 고쳐서는 해결되지 않아 데이터 보완이 추가됩니다. 기존 범위를 유지하면 재산정하고, 마감이 고정이면 해당 유형을 이번 범위에서 제외합니다”처럼 새로 확인한 사실 → 영향 → 선택지를 공유합니다.
AS-IS는 점수 하나가 아니라, 실행의 증거입니다.
평시에는 입력·채점·실행 조건과 원출력을 남깁니다. 긴급 차단 때는 차단을 늦추지 않는 범위의 사건 기록부터 확보하고, 재현 환경과 정식 비교는 후속으로 보완합니다.
점수만이 아니라, 어떤 실행에서 나온 결과인지 남깁니다.
logging parameters, code versions, metrics, and output files
한국어 번역파라미터, 코드 버전, 지표, 출력 파일을 기록하기
원문의 맥락MLflow는 실행(run)을 중심으로 파라미터·코드 버전·측정값·출력 파일을 기록하고 비교하는 추적 모델을 설명합니다.
이 문서의 적용이 문서에서는 이를 manifest와 사례별 원출력으로 나눕니다. 프롬프트·모델·문서 시점·채점 버전까지 연결해 AS-IS와 TO-BE를 같은 방식으로 보관합니다.
적용의 한계위 필드 목록은 LLM 서비스에 맞춘 실무 제안입니다. MLflow 설치가 필수이거나, 기록만으로 외부 모델의 완전 재현이 보장되지는 않습니다.
사건 ID · 시각 · 현재 버전 · 증상/영향 · 조치자 · 차단 내용 · 확인 결과부터 남깁니다. 저장하지 못한 과거값을 추정해서 채우지 말고 “미확보”로 표시합니다. 정식 수정 시 아래 실행 명세와 평가 증거를 보완합니다.
| 최소 기록 | 무엇을 남기는가 | 빠뜨리면 생기는 문제 |
|---|---|---|
| 시스템 식별 | commit, 실제 프롬프트·설정, 모델 ID, 실행 환경 참조 | 같은 코드라도 다른 시스템을 비교하게 됩니다. |
| 데이터 기준 | 원천 문서 스냅샷·시점, 실제 인덱스 버전, 도구 초기 상태 | 성능 차이가 로직 때문인지 데이터 변경 때문인지 모릅니다. |
| 평가 계약 | case ID, 데이터셋 해시, 정답·허용 조건, 채점·평가 코드 버전 | 시험지나 채점기가 바뀌어 점수를 직접 비교할 수 없습니다. |
| 사례별 원결과 | 입력 참조, 원출력, 성공·실패, 검색·도구 흔적, 시간·토큰 | 평균만 남고 회귀 원인을 다시 볼 수 없습니다. |
| 측정 조건 | 실행 시각, 부하·캐시·재시도·타임아웃, 실행 실패 | 느려진 원인이 버전인지 환경인지 구분하기 어렵습니다. |
실행 단위로 파라미터·코드 버전·지표·결과물을 추적하는 개념은 MLflow 문서에서 확인할 수 있습니다. 위 최소 필드는 LLM 서비스에 맞춰 확장한 제안입니다. [4]
“prompt_v7”만 적지 않습니다.
실제 내용이 고정된 파일이나 저장 위치, 해시를 연결합니다. 검색 인덱스의 alias는 가리키는 대상이 바뀔 수 있으므로 고정 스냅샷의 대용이 아닙니다.
청크를 개선한다면 청크는 달라집니다.
원문 스냅샷·질문·채점 기준은 맞추되, 실험 대상인 청크와 인덱스는 버전별로 달라지는 것이 정상입니다. 통제 변수와 변경 변수를 구분합니다.
복사 가능한 AS-IS 실행 명세 보기
# 예시 구조입니다. 실제 비밀값이나 개인정보를 넣지 않습니다.
run_id: baseline-001
recorded_at: "2026-09-19T13:00:00+09:00"

system:
  git_commit: "<commit hash>"
  working_tree_clean: true
  runtime_artifact: "<container digest 또는 lockfile>"
  model_id: "<실제 요청한 모델 ID>"
  model_snapshot: "<제공되는 경우 고정 버전>"
  prompt_artifact: "prompts/answer_v7.txt"
  config_artifact: "configs/search_v7.yaml"

data:
  source_snapshot: "kb_demo_v12"     # 원문 기준 시점 고정
  index_artifact: "card_index_v12"   # 별칭만으로 대체하지 않음

evaluation:
  dataset: "card_eval_v4.jsonl"
  dataset_hash: "<sha256>"
  grader_version: "rubric_v2"
  harness_commit: "<평가 코드 commit>"
  trials_per_case: 1                 # 중요한 흐름은 별도 반복 설계

measurement:
  concurrency: 1
  cache_policy: "<동일한 캐시·워밍업 정책>"
  timeout_and_retry: "<공통 타임아웃·재시도 정책>"

artifacts:
  cases: "runs/baseline-001/cases.jsonl"
  summary: "runs/baseline-001/summary.json"
trace_location: "<권한 제한된 보관 위치>"외부 모델이 종료되거나 제공자 내부 동작이 바뀌면 같은 호출을 다시 실행하기 어려울 수 있습니다. 그래서 당시의 실제 출력과 측정값을 함께 보관합니다. 개인정보는 최소 수집·마스킹하고, 비밀키와 원본 고객 데이터를 Git에 넣지 않습니다. 보관 기간과 접근 권한도 정합니다. [3] [11]
이미 개발해서 과거가 사라졌다면? / 완전히 신규 기능이라면?
별도 환경에서 기준 버전을 다시 실행합니다. 당시 실측이 아니라 현재 조건에서 재구성한 기준선임을 표기합니다.
동일한 새 채점 기준으로 품질을 재채점할 수 있습니다. 당시 지연시간·비용이 없으면 그 항목은 “비교 불가”로 남깁니다.
수작업, 기존 검색·규칙, 단순 프롬프트 같은 합리적인 대안을 비교 대상으로 둡니다. 대안도 측정하지 못했다면 이번 측정을 최초 기준선으로 선언합니다. “기존보다 개선”이라는 숫자를 만들지 않습니다.
같은 시험지보다 먼저, 무엇을 합격으로 볼지 정합니다.
평가셋은 입력 목록만이 아닙니다. 초기 상태·허용 가능한 정답·채점 규칙·버전이 함께 있어야 비교할 수 있습니다.
명확한 날짜·권한·중복 처리 오류는 코드·통합 검사로 우선 검증하고, 의미적 품질은 정성 Eval로 확인합니다. 모든 항목을 매번 똑같이 수행하지 않되, 비대상·미룸의 이유를 기록합니다. 변경 대상별 최소 검증 →
원래 잘하던 것을 지켰나?
대표 정상 흐름과 과거에 고친 버그를 넣습니다. 개발 중 반복 확인하는 세트입니다.
이번에 무엇을 더 잘하나?
현재 부족한 질문과 새 기능을 의도적으로 포함합니다. 문제 해결과 진단에 사용합니다.
보지 않은 사례에도 통하나?
반복 튜닝에 사용하지 않은 표본으로 확인합니다. 개발 때 매번 보면 더 이상 독립 확인셋이 아닙니다.
능력 평가와 회귀 평가의 구분은 Anthropic, 업무별 평가와 지속적인 데이터 보완은 OpenAI의 가이드를 참고했습니다. [1] [2]
새 능력의 개선과 기존 능력의 보존은 다른 질문입니다.
Does the agent still handle all the tasks it used to?
한국어 번역에이전트가 예전에 처리하던 모든 작업을 여전히 처리하나요?
원문의 맥락Anthropic은 어려운 문제의 개선을 보는 능력 평가와, 기존 동작의 후퇴를 감지하는 회귀 평가를 구분합니다. 안정화한 능력 평가를 회귀 세트로 옮기는 흐름도 제시합니다.
이 문서의 적용이번 목표 영역의 점수와 기존 성공→실패 사례를 함께 봅니다. purpose·origin·severity를 나누어 실패의 출처와 중요도까지 기록합니다.
적용의 한계실제 실패 20~50건은 초기 진단의 출발점이라는 조언입니다. 충분한 표본 수나 운영 품질의 통계적 보증을 뜻하지 않습니다.
한 데이터셋에 purpose를 붙여 시작할 수 있습니다. critical은 위험 등급, production_failure는 사례 출처입니다. 둘은 회귀·도전과 같은 배타적 분류가 아닙니다. 하나의 사례가 “운영 실패에서 온 중요 회귀 사례”일 수 있습니다.
| 필드 | 예시 | 확인하려는 것 |
|---|---|---|
case_id | CARD-012 | 버전 간 동일 사례 연결 |
input / initial_state | 질문·대화 이력·사용자 권한·조회 기준일 | 정말 같은 문제를 푸는지 |
expected / rubric | 허용 문서 ID 집합, 필수 조건, 금지 행동 | 복수 정답과 중요한 제약을 허용·검사 |
purpose / origin / severity | regression / production / critical | 목적·출처·위험을 구분 |
reference_version | 정책·문서 기준 시점 | 만료되거나 바뀐 정답인지 |
평가셋이 없으면
실제 실패와 대표 정상 사례로 20~50건 정도의 진단용 시작점을 만들 수 있습니다. 큰 효과나 명백한 버그를 찾는 용도이지, 운영 품질을 통계적으로 보증하는 숫자는 아닙니다. [2]
평가셋이 이미 있으면
현재 정책·문서·사용자 권한과 맞는지 확인합니다. 채점 기준이 바뀌면 양쪽 결과를 새 기준으로 다시 채점하거나 재실행합니다. 서로 다른 버전의 점수를 그대로 뺄셈하지 않습니다.
진단셋은 의도적으로 어려운 사례를 많이 담습니다. 운영 품질을 추정하려면 대표 표본 또는 운영 비중을 반영한 집계가 필요합니다. 같은 원문에서 만든 유사 질문은 독립적인 새 증거로 과대계산하지 않습니다. 합성 질문의 정답도 검수합니다. [1]
정성평가와 LLM-as-a-Judge는 어떻게 최소 구성할까?
점수가 낮다는 현상과, 그 원인을 구분합니다.
“답변이 틀림 → 프롬프트 수정”으로 바로 건너뛰지 않습니다. 어떤 단계에서 실패했는지 확인한 뒤 가장 작은 변경을 선택합니다.
RAG 진단 순서
원천 누락·만료·권한 필터 문제부터 확인합니다.
검색 누락, 순위, 중복 제거, 문맥 잘림을 구분합니다.
조건 누락, 근거와 모순, 답변 형식 문제를 봅니다.
검색 과정과 생성 결과를 별도로 평가하는 근거: [5]
RAG는 검색 과정과 최종 답변을 나누어 진단합니다.
Process evaluation assesses the quality of the document retrieval step in RAG systems.
한국어 번역과정 평가는 RAG 시스템의 문서 검색 단계 품질을 평가합니다.
원문의 맥락Microsoft는 문서 검색 품질을 평가하는 과정 평가와, 최종 답변의 근거 충실성·관련성·완전성을 보는 시스템 평가를 구분합니다.
이 문서의 적용검색 결과에 정답 문서가 없었던 것인지, 올바른 문서를 받고도 답변을 잘못 만든 것인지 먼저 가릅니다. 원문·검색 결과·최종 문맥·답변을 함께 남깁니다.
적용의 한계이 구분은 원인 분석을 돕는 틀입니다. 높은 groundedness가 답변의 완전성이나 실제 업무 성공까지 보장하지는 않습니다.
“혜택 조건이 청크 밖으로 잘려 검색되지 않는다”는 가설을 세웠다면, 원문과 모델은 고정하고 조건이 함께 들어가는 청크 구성만 먼저 바꿉니다. 검색 누락 사례가 실제로 개선되는지 확인합니다.
| 서비스 유형 | 일반 테스트 | LLM 평가에서 추가할 것 |
|---|---|---|
| RAG | 적재·필터·인덱스·API 정합성 | 검색 적중과 답변 성공을 분리, 근거·시점·권한 검증 |
| Agent / 도구 | 인자 검증·인증·멱등성·예외 처리 | 올바른 도구와 결과 상태, 불필요한 재시도, 승인 없는 실행 |
| 생성·요약 | 입출력 형식·길이·템플릿 제약 | 사실 오류·중요 내용 누락·금지 표현·사람 수정량 |
| 분류 | 라벨 스키마·후처리·예외 입력 | 클래스별 재현율, 중요 오분류, UNKNOWN·보류의 적절성 |
위 표는 업무별 실행 가능 검증과 정성 채점을 구분하라는 원칙의 실무 적용 예시입니다. [1] [2] [5]
작게 바꿔야 원인을 알 수 있습니다.
모델·프롬프트·검색을 동시에 바꿔도 “전체 묶음의 개선”은 비교할 수 있습니다. 다만 무엇 때문에 좋아졌는지는 분리할 수 없습니다. 원인 설명이 필요할 때만 요소를 제거하는 비교 실험을 추가합니다. 항상 모든 조합을 실험할 필요는 없습니다.
실패 빈도만으로 우선순위를 정하지 않습니다.
가장 흔한 실패보다 드물지만 큰 피해를 주는 권한 누출·오실행을 먼저 막아야 할 수 있습니다. 빈도 + 업무 영향 + 수정 가능성을 함께 보고 선택합니다.
LLM이 매번 다르게 답한다면?
변동이 크거나 중요한 사례는 양쪽 버전에 같은 반복 정책을 적용하고 trial별 결과를 남깁니다. 5번 중 4번 성공은 한 번 성공했다는 사실보다 많은 정보를 줍니다. 하지만 같은 질문의 다섯 번 실행은 독립적인 질문 다섯 개가 아닙니다. [2]
도구 상태·대화 이력을 매 실행에서 초기화하고, 쓰기 도구는 검증 환경에서 실행합니다. 재시도 한도와 캐시 조건이 달라지면 품질뿐 아니라 비용·지연시간도 함께 달라집니다. 반복 횟수는 위험과 비용을 고려해 정하며, 모든 테스트를 무조건 여러 번 돌리는 규칙은 두지 않습니다.
“84%입니다”가 아니라, “78%에서 무엇이 바뀌었나”를 말합니다.
같은 사례를 양쪽에 실행하고, 개선된 사례와 새로 실패한 사례를 연결합니다. 아래 숫자는 서로 일치하도록 구성한 가상 예시입니다.
품질 개선은 전후 성공률·회귀를, 단순 버그는 결함의 재현·해소를, 긴급 대응은 영향·차단 효과·미해결 상태를, 시한부 위험은 해당 조건 통과를 보고합니다. 모든 수정을 정확도 상승 수치로 포장하지 않습니다.
평균 뒤에 숨은 변화
성공
실패
순증가 30건 = 개선 50건 − 회귀 20건
+6.0%p = 30 ÷ 500 × 100
반드시 함께 보고할 숫자
전체 성공률과 이번에 고치려던 유형을 함께 봅니다.
20 / 전체 500 = 4.0%
20 / 기존 성공 390 = 약 5.1%
둘은 다른 지표입니다.
평균 상승만으로 중요한 기능의 악화를 상쇄하지 않습니다.
지표는 쉬운 숫자보다 사용자에게 중요한 결과를 향해야 합니다.
what your users care about, not what you can measure.
한국어 번역측정 가능한 것이 아니라, 사용자가 중요하게 여기는 것.
원문의 맥락Google SRE는 사용자가 중요하게 여기는 결과에서 출발해 지표와 목표를 정하라고 설명합니다. 측정하기 쉬운 숫자부터 고르면 덜 유용한 목표가 될 수 있다는 취지입니다.
이 문서의 적용검색 점수만 보고하지 않고 업무 성공·중요 실패·응답시간·비용을 함께 봅니다. 이 문서의 성공 업무당 비용은 실패·재시도 비용을 숨기지 않기 위한 적용 예시입니다.
적용의 한계이 자료가 아래 가상 수치나 특정 합격선을 정해주지는 않습니다. 어떤 지표를 우선할지는 서비스 목적에 따라 합의합니다.
| 지표 | AS-IS | TO-BE | 변화 / 해석 |
|---|---|---|---|
| 고정 평가셋 성공률 | 390/500 · 78.0% | 420/500 · 84.0% | +6.0%p |
| 혜택 질의 성공률 · 전체 중 200건 | 120/200 · 60.0% | 146/200 · 73.0% | +13.0%p |
| 새로운 회귀 / 전체 사례 | — | 20/500 · 4.0% | 영향도 검토 필요 |
| 중요 사례 실패 · 전체 중 40건 | 0/40 | 0/40 | 이 표본에서 미관측 |
| p95 전체 응답시간 | 1.32초 | 1.47초 | +0.15초 · 약 11.4% |
| 실패 비용 포함 / 성공 업무 | 12.0원 | 13.2원 | +10.0% |
비용 예시: 전체 호출 비용 4,680원 ÷ 성공 390건, 5,544원 ÷ 성공 420건. 실제 API 단가를 뜻하지 않습니다. 지연시간·오류·비용 등 여러 실행 지표를 함께 보는 근거: [2] [9]
관측된 평균은 좋아졌지만 회귀 20건의 영향과 허용 여부를 확인해야 합니다. 중요 사례 40건에서 오류가 없었다고 전체 서비스의 무오류를 증명한 것도 아닙니다. 여기에는 신뢰구간이나 운영 개선의 인과효과를 계산했다는 주장도 포함하지 않습니다.
30초 보고문 · 가상 예시
문제 → 결과 → 위험 → 결정 요청혜택 조건 검색의 누락을 줄이기 위해 청크 구성을 개선했습니다. 동일한 평가셋 500건에서 성공률은 78%에서 84%로 6%p 올랐고, 실패 50건을 해결하는 동안 기존 성공 20건에 회귀가 발생했습니다. 중요 사례 40건에서는 오류가 관측되지 않았습니다. p95 응답시간은 1.32초에서 1.47초, 성공 업무당 비용은 12원에서 13.2원으로 늘었습니다. 회귀 영향도 검토와 승인 후 제한 배포 여부를 결정해 주시면 됩니다. 실제 사용자 성과는 배포 후 별도로 확인하겠습니다.
심화: 평균 차이의 불확실성은 어떻게 확인할까?
동일 사례의 신규 점수 − 기존 점수를 계산하고, 사례 쌍을 유지해 bootstrap 신뢰구간을 추정할 수 있습니다. 반복 trial이 있으면 적어도 case 단위 묶음을 보존합니다. 유사 질문이 문서·세션 단위로 묶여 있다면 그 상관도 고려해야 합니다. [12]
통계적으로 차이가 뚜렷하지 않다는 것이 “동등함”의 증명은 아닙니다. 허용 가능한 저하 폭이나 의미 있는 최소 개선 폭을 먼저 정의합니다. 대표성이 없는 평가셋의 문제를 신뢰구간만으로 해결할 수도 없습니다.
같은 질문끼리의 짝을 유지해야 비교 구조가 보존됩니다.
uses the same indices for all arrays in data
한국어 번역data의 모든 배열에 같은 인덱스를 사용합니다.
원문의 맥락SciPy의 paired=True는 두 배열을 따로 뽑지 않고 같은 인덱스로 재표집합니다. 동일 사례의 AS-IS·TO-BE 관측 쌍을 함께 선택하는 데 활용할 수 있습니다.
이 문서의 적용case_id로 양쪽 결과를 먼저 연결하고 그 쌍의 차이를 분석합니다. 반복 시행이나 같은 문서의 유사 질문은 독립 표본처럼 늘리지 않고 묶음 구조도 고려합니다.
적용의 한계함수 옵션의 설명이지, 특정 표본 설계의 타당성 보증은 아닙니다. 위 500건 가상 예시에는 신뢰구간을 계산했다는 주장이 없습니다.
직접 숫자를 바꿔보는 개선·회귀 계산기
학습용 계산기입니다. 실제 평가를 실행하지 않으며 입력값을 외부로 보내지 않습니다.
배포 승인은 점수, 안전, 복구의 세 문을 통과합니다.
평시에는 사전 기준을 통과한 뒤 노출합니다. 피해를 줄이는 긴급 차단·복구는 사전 정의한 비상 절차로 가속할 수 있지만, 위험·미룬 검증·후속 책임을 별도로 남깁니다.
신뢰할 수 있는 서비스에는 반복 가능한 배포 과정이 필요합니다.
Running reliable services requires reliable release processes.
한국어 번역신뢰할 수 있는 서비스에는 신뢰할 수 있는 릴리스 과정이 필요합니다.
원문의 맥락Google SRE는 소스에서 빌드·설정·시험·배포까지의 과정과 산출물이 의도적이고 재현 가능해야 한다고 설명합니다.
이 문서의 적용후보 버전의 평가 결과뿐 아니라 배포할 코드·프롬프트·모델·설정·인덱스의 조합, 승인, 감지·중단·복구 계획까지 한 묶음으로 남깁니다.
적용의 한계이 원칙을 세 개의 배포 게이트로 구성한 것은 이 문서의 적용입니다. Google의 전체 조직이나 도구를 그대로 도입하라는 뜻은 아닙니다.
아래 게이트는 새 후보를 사용자에게 노출하는 기본 판단입니다. 진행 중 피해를 차단하는 조치는 조직의 비상 절차에 따라 먼저 수행할 수 있으며, 필요한 확인과 기록을 병행합니다. 새로운 핫픽스의 검증·승인 요구와 단순 기능 OFF를 동일하게 취급하지 않습니다. [19]
01 · 품질
비교의 문같은 평가 조건인가? 목표 영역이 좋아졌나? 회귀 사례의 영향도와 처리 결정이 남았나?
증거: 비교표 + 회귀 목록02 · 안전·성능
운영의 문권한·개인정보·오실행 차단, 오류·타임아웃·부하·비용이 서비스의 허용 범위 안에 있나?
증거: 필수 시험 결과 + 위험 검토03 · 감지·복구
대응의 문새 버전 문제를 구분해 볼 수 있나? 누가 언제 중단하며 무엇을 되돌릴지 준비했나?
증거: 배포·롤백·관찰 계획재현·검증 가능한 릴리스와 점진 노출, Agent의 방어 계층을 참고해 구성한 배포 게이트입니다. [6] [7] [11]
| 결정 | 어떤 상태인가 | 다음 행동 |
|---|---|---|
| 진행 | 사전 기준 충족, 중요 회귀 없음, 잔여 위험 승인, 감지·복구 준비 | 승인된 범위부터 제한 배포 |
| 보류 | 효과가 불확실하거나 회귀·성능·데이터 문제가 미해결 | 추가 진단, 수정, 재평가 또는 범위 축소 |
| 중단 | 권한 누출, 승인 없는 실행 등 차단 사유 확인 | 노출 차단·원인 제거. 일정 압박으로 예외 처리하지 않음 |
정확도 상승과 바꿀 수 없는 안전 조건을 먼저 구분합니다. 허용할 품질 저하·응답시간·비용과 승인권자는 업무 위험에 맞춰 사전에 정합니다. 체크리스트 완료 표시가 조직의 배포 승인을 대체하지는 않습니다.
코드만이 아니라, 시스템 묶음을 되돌립니다.
중복 실행 방지, 사용자 승인, 도구 권한, 실행 이력, 필요한 보상 조치를 별도로 설계합니다. 실제 쓰기 작업을 두 시스템에 동시에 보내는 shadow 평가는 피하고, 샌드박스나 실행 없는 모의 도구로 먼저 검증합니다. [2] [11]
구버전이 같은 누출을 포함하거나 외부 모델이 종료됐다면 롤백이 안전한 해법이 아닙니다. 되돌리는 것보다 어떤 상태가 안전한지 먼저 판단합니다.
도구 실행 권한은 품질 점수와 별도로 통제합니다.
Keep tool approvals on
한국어 번역도구 승인 기능을 켜두세요.
원문의 맥락해당 가이드는 Agent Builder에서 MCP 도구를 사용할 때 읽기·쓰기를 포함한 작업을 사용자가 확인하도록 승인 기능을 켜라고 권고합니다.
이 문서의 적용예약·발송·정보 변경 같은 영향이 큰 작업의 승인과 권한, 중복 실행 방지, 실행 이력을 별도 검증합니다. 이미 생긴 업무 변경은 코드 롤백만으로 취소되지 않습니다.
적용의 한계제품별 권고의 적용 맥락을 밝힌 인용입니다. 승인 기능 하나로 모든 프롬프트 인젝션이나 오실행 위험이 제거되는 것은 아닙니다.
카나리는 일부에 배포한 뒤 평가하고 확대 여부를 정하는 과정입니다.
a partial and time-limited deployment of a change in a service and its evaluation.
한국어 번역서비스 변경을 일부에 제한된 기간 배포하고 평가하는 것.
원문의 맥락Google SRE는 일부·한정 기간 배포와 평가를 하나로 정의합니다. 신규 버전의 영향을 기존 버전과 비교하고, 그 결과를 확대·중단 판단에 연결해야 합니다.
이 문서의 적용노출 비중만 적지 말고 버전별 지표, 관찰량, 중단 조건, 복구 담당자를 정합니다. 전체 평균이 아니라 신규 버전의 오류·지연·중요 실패를 구분해 봅니다.
적용의 한계5%→10% 같은 비율이나 일정한 관찰 시간은 이 자료가 보장하는 정답이 아닙니다. 실제 트래픽과 위험에 맞춰 정합니다.
카나리: 안전하게 확대할 수 있나?
일부 요청에 신규 버전을 적용해 장애와 회귀를 감지합니다. 노출 비중·최소 관찰량·중단 기준을 정합니다. 트래픽이 적으면 내부 사용자나 제한 기능부터 시작할 수 있습니다. [7]
A/B 실험: 사용자 성과가 개선됐나?
효과를 추정하려면 적절한 무작위 배정, 비교 단위와 관찰 기간이 필요합니다. 같은 라우팅 기술을 쓰더라도 카나리 배포 자체가 사업 성과 개선을 입증하는 실험은 아닙니다. [8]
안전한 배포 확인과 사업 효과 입증을 혼동하지 않습니다.
it is preferable to avoid conflating these two concerns
한국어 번역이 두 목적을 혼동하지 않는 편이 바람직합니다.
원문의 맥락Danilo Sato는 카나리의 회귀·문제 감지와 A/B 실험의 가설 검증을 구분합니다. 같은 라우팅 기술을 사용해도 판단하려는 질문은 다를 수 있습니다.
이 문서의 적용“새 버전에서 문제가 감지되지 않았다”와 “새 버전 때문에 사용자 성공률이 올랐다”를 별도로 보고합니다. 후자는 배정·관찰·교란 요인을 고려한 효과 검증이 필요합니다.
적용의 한계Google SRE는 넓은 의미에서 카나리를 A/B 과정이라고도 부릅니다. 여기서는 용어를 배타적으로 나누는 대신, 운영 안전 확인과 인과효과 주장의 차이를 구분합니다. 함께 확인: 출처 [7]
급할수록 줄일 것은 변경 범위입니다.
운영 배포의 필수 안전장치를 조용히 빼지 않습니다.
예외는 “검증 안 함”이 아니라 “다르게 통제함”입니다.
비상 절차는 담당자의 감으로 만드는 지름길이 아닙니다. 조정한 절차, 대체 안전장치, 승인·위임 권한, 만료와 후속 책임을 남깁니다.
긴급 가속을 누가 어떤 조건에서 허용하는지 먼저 정합니다.
Make sure that you define who can approve SDP acceleration in an emergency
한국어 번역비상 상황에서 안전 배포 절차의 가속을 누가 승인할 수 있는지 정하세요.
원문의 맥락Microsoft는 긴급 상황에서 승인·검사·관찰을 가속하는 절차를 별도로 정의하고, 제한된 테스트도 가능한 빨리 별도로 실행하도록 설명합니다.
이 문서의 적용조직에서 위임한 권한으로 먼저 차단한 조치는 즉시 공유·기록하고, 긴급 패치의 미룬 검증에는 담당자와 기한을 연결합니다.
적용의 한계임원 요청이 곧 비상 승인이라는 뜻은 아닙니다. 이 문서의 예외 기록 양식은 적용 예시이며, 조직의 보안·운영 통제를 대체하지 않습니다.
영향·권한·변경 기록
누구에게 어떤 피해인지, 무엇을 어떤 권한으로 바꾸는지, 조치가 먹혔는지, 다음 책임자가 누구인지 남깁니다. 차단과 동시에 남길 수 있는 최소 기록부터 시작합니다.
순서·검증량·관찰 방식
관련 없는 대규모 평가, 긴 문서, 단계 간 대기를 줄이거나 뒤로 미룰 수 있습니다. 자동 실행이 빠른 공통 검사는 유지하고, 생략·비대상·미룸을 구분합니다.
증거 조작·위험 은폐
실패를 분모에서 빼기, 미검증을 통과로 쓰기, 비밀값을 로그로 흘리기, 데모를 운영 완료라 부르기, 무기한 임시 조치는 일정으로 정당화하지 않습니다.
| 상태 | 정확한 뜻 | 다음 행동 |
|---|---|---|
| 비대상 | 변경 영향이 없어 해당 검증을 수행하지 않음 | 영향 분석 사유 기록. 무조건 나중에 돌릴 의무는 없음 |
| 미룸 | 필요한 검증이나 지금은 피해 차단·긴급 조치 때문에 못함 | 대체 통제 + 담당자 + 기한 + 미달 시 조치 |
| 잔여 위험 승인 | 확인된 제한을 권한 있는 담당자가 허용된 범위에서 수용 | 허용 범위·기간·철회 조건 기록. 금지된 행위를 허용하는 만능 예외 아님 |
기한이 지나면 재승인·상향 보고·안전 상태 유지 여부를 판단합니다. 해제는 검증과 승인 조건을 충족한 뒤 수행합니다. 기능 OFF·읽기 전용·배치 정지에는 서비스 저하와 수동 업무가 생기므로 그 영향도 함께 보고합니다.
상황이 끝났다는 말도 세 단계로 나눕니다.
사건 대응 자체는 서비스가 안정되면 종료할 수 있습니다. 다만 근본 수정, 이미 잘못 처리한 데이터의 정정, 미룬 검증, 임시 설정 제거는 연결된 후속 작업으로 계속 추적합니다. 조직의 사건 종료 기준과 후속 완료 기준을 혼용하지 않습니다.
혼자 대응할 때도 책임은 구분합니다.
여러 직함을 만들 필요는 없습니다. 실행 담당·상태 공유 창구·승인 또는 사전 위임 권한을 기록합니다. 혼자 판단할 권한이 없으면 기능 제한과 함께 에스컬레이션하며, 인계에는 현재 상태·남은 위험·다음 점검을 포함합니다. [18]
긴급 작업이 반복되면 계획을 바꿉니다.
계속되는 예외를 개발자의 야근으로 흡수하지 않습니다. 원인군별 반복 건수, 미완료 검증, 자동화·관찰 공백을 근거로 안정화 작업을 우선하도록 합의합니다. Google의 error budget 정책은 이런 우선순위 전환의 한 예입니다. [20]
해당 출처의 수치와 예외 규정은 예시 서비스의 정책이지 모든 회사의 의무 기준이 아닙니다.
예외 상황에서 특히 조심할 실수
| 흔한 말 | 놓치는 위험 | 바꿀 행동 |
|---|---|---|
| “원칙상 Baseline부터 돌려야죠.” | 진행 중 피해의 차단이 늦어짐 | 차단 우선, 최소 증거 병행, 정식 평가 후속 |
| “팀장님이 P0라고 하셨어요.” | 업무 우선순위와 피해 등급이 섞임 | 영향·시한·우선순위 근거와 미룰 작업을 분리 |
| “한 줄이라 테스트는 생략해요.” | 공통 프롬프트·권한·파서 전체 영향 | 수정량이 아닌 실행 경로·공유 범위로 검증 결정 |
| “지금 안 터졌으니 다음 주에 해요.” | 배치·만료·누적 시점이 먼저 도래 | 최초 피해 시점과 복구 여유 역산 |
| “롤백했으니 원복됐습니다.” | 외부 도구 실행·오염 데이터·캐시가 남음 | 이미 발생한 상태 변화와 후속 정정 별도 확인 |
| “Canary 5%니까 안전해요.” | 일부라도 유출·오실행 피해 발생 가능 | 고위험 경로는 먼저 모의·읽기 전용 검증. 비율로 안전을 보증하지 않음 |
| “전체 점수는 좋아졌어요.” | 중요 회귀·신규 거부로 업무 중단을 숨김 | 중요 실패, 허용 요청 성공, 차단 부작용을 분리 |
| “급해서 나중에 정리할게요.” | 검증·임시 조치가 영구 미완료가 됨 | 기록에 담당·기한·만료 후 조치부터 지정 |
| “재현도 안 되고 신고도 없어요.” | 관측·트래픽 부족을 무오류로 오해 | 사용량·로그 범위·조건 통과를 확인하고 미확정 표시 |
위험을 줄이기 위해 순서를 바꾸고, 바꾼 이유와 남은 일을 다음 사람이 이어받을 수 있게 만듭니다.
배포 후에는 “실제로 좋아졌는가”를 확인합니다.
Offline Eval은 제한된 조건의 증거입니다. 운영에서는 입력 분포, 사용자의 행동, 외부 도구와 정책 변화까지 다시 만납니다.
개발·평가의 안쪽 순환만으로 서비스 운영이 끝나지 않습니다.
The outer loop focuses on deploying and managing solutions in production.
한국어 번역바깥 순환은 운영 환경에 솔루션을 배포하고 관리하는 데 집중합니다.
원문의 맥락Microsoft는 개발·시험·개선의 내부 순환과 운영 배포·관리의 외부 순환을 구분합니다. 모니터링과 사용자 피드백으로 검증 데이터를 보완하는 단계도 포함합니다.
이 문서의 적용배포 전에 관찰 담당자와 지표를 정합니다. 운영에서 수집한 실패는 민감정보 제거·재현·정답 검수를 거친 뒤 다음 평가셋에 반영합니다.
적용의 한계LLMOps의 생애주기 설명입니다. 배포 후 관측된 모든 변화가 이번 변경의 인과효과라는 뜻은 아닙니다.
시간 조건 버그는 실제 경계·배치 주기를 지난 결과를, 누적 오류는 충분한 부하·시간의 추세를 확인합니다. 패치 직후의 정상 응답 하나나 신고 부재만으로 종료하지 않습니다. 임시 제한의 정상 요청 차단·수동 업무 부담도 함께 봅니다.
| 관찰 영역 | 최소 지표 예시 | 주의할 해석 |
|---|---|---|
| 서비스 건강성 | 버전별 오류율·타임아웃·p95, 요청량 | 전체 평균만 보면 일부 버전이나 사용자 문제를 놓칩니다. |
| 업무 성과 | 실제 작업 완료, 수동 전환, 수정량, 포기·재질문 | 재질문 감소가 만족 증가일 수도, 포기 증가일 수도 있습니다. |
| LLM 품질 | 대표 표본과 위험 표본의 사람 검토, 검증된 judge, 중요 실패 | 자동 채점은 오판할 수 있으므로 주기적으로 점검합니다. |
| 비용·도구 | 성공 업무당 총비용, 토큰, 재시도, 도구 실패, rate limit | 실패·재시도 비용을 빼고 성공 요청만 계산하지 않습니다. |
운영 모니터링·사용자 피드백을 평가 데이터로 연결하는 LLMOps 구조와, 사용자 중심 지표 설계 원칙을 적용한 예시입니다. [3] [9]
언제, 누가 확인하나요?
배포 직후에는 장애·오실행을, 충분한 사용량이 쌓인 뒤에는 품질과 업무 성과를 봅니다. 관찰 담당자·시간대·최소 요청량·알림 수신자·중단 기준을 배포 전에 정해둡니다.
“3일 지났으니 성공”처럼 달력만 보지 않습니다. 요일·행사·질문 유형 변화가 섞이면 단순 배포 전후 비교를 인과효과로 해석하지 않습니다.
실패를 평가 자산으로 바꾸는 순서
실패 수집 → 민감정보 제거 → 재현 → 올바른 기대 결과 검수 → 사례 등록 → 수정과 재검증.
중복을 정리하고 기존 평가셋은 새 버전으로 관리합니다. 운영 원본 로그 전체를 무조건 영구 보관하지 않습니다. 정책이 바뀌면 오래된 “정답”도 갱신하거나 폐기합니다.
일반 오류는 사례와 수정 기록으로 남기고, 중요한 장애는 영향·기여 원인·감지 지연·재발 방지·담당자·기한을 기록합니다. 목적은 개인을 평가하는 것이 아니라 같은 실패를 더 빨리 막는 시스템을 만드는 것입니다. [10]
회고의 결과는 비난이 아니라 재발 방지 조치여야 합니다.
Writing a postmortem is not punishment—it is a learning opportunity for the entire company.
한국어 번역장애 회고는 처벌이 아니라 조직 전체의 학습 기회입니다.
원문의 맥락Google SRE는 중요한 장애의 영향과 기여 원인을 기록하고, 재발 가능성이나 영향을 줄일 예방 조치를 남기는 학습 과정을 강조합니다.
이 문서의 적용사례 ID·영향·감지 실패·수정·회귀 평가·담당자·기한을 연결합니다. “주의하겠습니다”보다 다음 변경에서 같은 실패를 자동으로 찾을 수 있게 만듭니다.
적용의 한계모든 경미한 오류에 긴 회고를 요구하지 않습니다. 회고가 필요한 조건을 미리 정하고, 작은 오류는 사례·수정 기록으로 관리합니다.
코드에 수정이 남고, 평가셋에 이유가 남고, 운영 기록에 효과가 남는 구조가 목표입니다.
다음 작업에서 그대로 꺼내 씁니다.
작업카드부터 배포 기록까지 복사해 사용하세요. 문서 양식을 늘리는 대신, 기존 이슈·PR에 필요한 항목만 붙이면 됩니다.
평가를 먼저 정의하고, 실행을 추적하고, 배포·운영을 연결한다는 원칙을 짧은 작업 기록으로 옮겼습니다. OpenAI·MLflow·Google의 공식 서식이 아니며, 팀의 승인·보안 규칙에 맞게 항목을 조정합니다. [1] [4] [6]
| 처음에는 이 정도 | 불편해질 때 추가 | 도구가 아니라 목적 |
|---|---|---|
| 이슈 하나 + Git + JSONL/CSV 결과 | 실행 추적 도구 | 과거 버전과 결과를 찾기 쉽게 |
| 짧은 핵심 평가 + 수동 확인 | CI의 회귀 평가, 독립 확인셋 | 변경마다 기존 기능을 빠뜨리지 않게 |
| 사람이 검토한 소수 사례 | 검증된 judge + 정기 감사 | 채점 기준을 유지하며 평가를 확대 |
| 제한 배포 + 담당자·복구 절차 | 자동 카나리·경보·정식 A/B 실험 | 노출 위험과 효과 검증을 관리 |
changes/search-benefit-001/
├── work.md                     # 범위·일정·완료 기준
├── eval_v1.jsonl + rubric.yaml  # 입력·정답·채점 계약
├── baseline-001/
│   ├── manifest.yaml
│   └── cases.jsonl
├── candidate-001/
│   ├── manifest.yaml
│   └── cases.jsonl
└── review.md # 비교·회귀·배포·운영 판단# LLM 서비스 변경 작업카드
## 대응 경로
- A 피해 차단 / B 시한부 예방 / C 일반 개선 / D 저위험 신속 수정:
- 현재·잠재 피해 / 시한 / 선택 근거:
- 재분류 조건 / 미룰 기존 작업:
## 문제와 범위
- 업무 / 사용자:
- 실패 현상과 재현 사례:
- 이번에 바꿀 것:
- 이번에 하지 않을 것:
- 요청자 / BA / 개발자 / 배포 승인권자:
## 완료와 성공 기준
- 납품 상태: 데모 / 검증 완료 / 배포 준비 완료
- 주 평가 지표와 합격 기준:
- 보존할 기능과 중요한 실패:
- 응답시간 / 비용 / 오류 허용 범위:
- 평가 미달 시 종료·추가 작업 결정 방식:
## 일정 산정
- 가정: 평가셋 / 원천 데이터 / 연계 환경 준비 여부
- 조사·재현:
- 기준선 확보·평가 준비:
- 구현:
- 전후 비교·회귀 분석:
- 배포 준비:
- 확인된 위험에 대한 여유:
- 실제 투입 가능 시간:
- 승인·연계 대기와 배포 시간대:
- 범위 확정 / 재산정 시점:
- 일정 변동 조건과 제외 사항:
## 증거 위치
- 고정 평가셋 / 채점 버전:
- AS-IS 실행 ID:
- TO-BE 실행 ID:
- 비교 보고서:
- 배포·복구 계획:
# 평가 실행 기록

run_id:
baseline_or_candidate:
recorded_at:

# 무엇을 실행했는가
code_commit:
runtime_or_lockfile:
model_id_and_snapshot:
prompt_and_config_artifact:
source_data_snapshot:
index_or_tool_state:

# 어떤 조건으로 평가했는가
dataset_version_and_hash:
rubric_and_grader_version:
eval_harness_version:
repetitions_and_initial_state:
concurrency_cache_timeout_retry:

# 무엇을 보관했는가
case_outputs_location:
summary_metrics_location:
sanitized_traces_location:
known_reproducibility_limits:

# cases.jsonl 권장 항목
# run_id, case_id, trial_id, input_ref, reference_version,
# actual_output, pass, score, error_type, retrieved_ids,
# tool_result_ref, latency_ms, input_tokens, output_tokens,
# total_cost, execution_status

# 타임아웃·실행 오류도 별도로 표시한다.
# 결과에서 조용히 제외하지 않고 업무 성공률 분모 정책을 명시한다.
# 개인정보 원본·비밀값은 넣지 않는다.
# AS-IS → TO-BE 비교 보고

## 한 문장 결론
[문제]를 위해 [변경]했습니다.
동일한 [평가셋 버전·건수·채점기]에서 [지표]가 [기존] → [신규]로 바뀌었습니다.
결론: 진행 / 제한 배포 검토 / 보류 / 중단

## 결과
| 항목 | AS-IS | TO-BE | 변화와 해석 |
| --- | ---: | ---: | --- |
| 업무 성공률 | | | |
| 목표 영역 | | | |
| p95 전체 응답시간 | | | |
| 실패 포함 비용 / 성공 업무 | | | |
| 오류·타임아웃 | | | |

- 유지(성공→성공):
- 개선(실패→성공):
- 회귀(성공→실패):
- 미해결(실패→실패):
- 전체 사례 수와 집계 분모:
- 중요 사례의 관측 오류 / 평가 건수:
- 주요 회귀의 영향과 처리:
- 통계적 불확실성 / 평가셋 한계:

## 의사결정
- 만족한 기준 / 미달한 기준:
- 잔여 위험과 승인 여부:
- 배포 범위 / 중단 기준:
- 운영 성과 확인 담당자와 시점:
- 추가로 필요한 결정:
# LLM 서비스 배포 기록

## 배포 대상
- 변경 ID / 배포 버전:
- 코드·프롬프트·모델·설정·인덱스 묶음:
- 비교 보고서:
- 승인권자 / 승인 시각:
- 검증되지 않은 범위와 잔여 위험:

## 시작·확대·중단
- 초기 대상: 내부 / 특정 기능 / 일부 사용자
- 초기 노출 비중과 확대 조건:
- 최소 관찰량과 기간:
- 버전별 모니터링 지표·분모·시간창:
- 중단 기준과 알림 수신자:
- 담당자 / 부재 시 연락 대상:

## 복구
- 신규 노출을 차단하는 방법:
- 검증된 이전 시스템 묶음:
- 설정·인덱스·상태 호환성 확인:
- 롤백 절차 검증 결과:
- 실행 중 요청 처리:
- 이미 발생한 쓰기·발송·예약의 확인 / 보상:

## 운영 확인
- 초기 오류·오실행 관찰 결과:
- 충분한 트래픽 이후 품질·업무 성과:
- 확정된 실패 사례와 eval 반영 버전:
- 확대 / 유지 / 복구 결정과 근거:
# 변경 위험·예외 판단 카드

## 영향과 처리 경로
- 이슈 / 사건 ID:
- 현재 관측 피해 / 잠재 피해 / 미확인 범위:
- 영향 대상·노출 범위 / 쓰기·민감정보 여부:
- 최초 피해 가능 시점 또는 누적 악화 조건 (시간대):
- 업무상 마감과 그 근거:
- 경로: A 피해 차단 / B 시한부 예방 / C 일반 개선 / D 신속 수정
- 경로 선택 이유 / 재분류 조건:
- 대신 미룰 업무와 합의자:

## 조치와 최소 증거
- 현재 버전·데이터·도구 상태 / 확보하지 못한 항목:
- 차단·우회·수정할 대상:
- 필수 사전 확인 / 즉시 확인할 효과:
- 부작용 / 이미 실행된 작업의 정정 필요:
- 비대상 검사와 영향 분석 사유:

## 예외가 있다면
- 미루거나 가속한 절차 / 이유:
- 대체 안전장치:
- 승인자 또는 사전 위임 권한 / 조치자:
- 남은 검증·영구 수정 / 담당자 / 기한:
- 임시 조치 재검토·만료 시각:
- 기한 미준수 시: 에스컬레이션 / 안전 상태 유지 / 재승인
- 임시 조치를 해제할 검증·승인 조건:
- 다음 상태 공유 시각 / 공유 창구:

## 종료
- 피해 완화 확인:
- 서비스 복구 확인:
- 후속 수정·검증·정정 완료 또는 연결 티켓:
- 사용자·업무 영향 확인 / 임시 설정·플래그 정리:
# 긴급 대응 상태 공유

[시각·시간대] [사건 ID] [담당·연락 창구]

확인한 사실:
- 현재 영향 / 영향을 받는 대상:
- 미확인 범위 / 현재 가설 (사실과 구분):

실행한 조치:
- 버전 / 차단 또는 복구 범위 / 조치 시각:
- 조치자 / 승인 또는 위임 권한:
- 차단 효과 / 남은 증상 / 조치 부작용:
- 진행 중 요청·대기 작업 / 이미 발생한 상태 변경:

현재 상태:
- 조사 중 / 피해 완화 / 서비스 복구 / 정식 수정·검증 완료
- 이번 단계에서 말할 수 없는 것:

다음 행동:
- 다음 확인·조치 / 담당자:
- 필요한 결정·지원:
- 미룬 검증·수정 / 담당자 / 기한:
- 다음 업데이트 시각:

※ 근거 없는 복구 완료 시각을 약속하지 않는다.
※ 사건 대응 종료와 후속 개선 티켓 종료를 별도로 관리한다.
※ 보안 사고는 해당 보안·통지 절차를 함께 따른다.
# 시한부·누적형 위험 작업 계획

- 이슈 / 담당자:
- 위험 조건: 배치 / 만료 / 외부 API 종료 / 누적 / 기타
- 최초 피해 가능 시각 (시간대) 또는 임계 조건:
- 현재 증상과 아직 증상이 없는 이유:
- 예상 영향 범위 / 근거와 불확실성:

## 일정 역산
- 재현·구현:
- 시간·상태 경계 검증:
- 승인·연계 대기:
- 배포:
- 복구·우회 여유:
- 작업 선후관계 / 병렬 가능 범위:
- 마지막 착수 시각 / 실제 착수 목표:
- 가용 시간·배포 창구 / 재산정 조건:

## 검증
- 기준 시각·시간대 / 원천 데이터·캐시:
- 직전·정각·직후 / 지연·재실행 / 누적 부하:
- 종료·전환 이후 구버전 사용 가능 여부:
- 필요한 관찰 주기·최소 사용량 / 담당자:

## 못 맞추면
- 예방 차단·수동 대체 범위:
- 차단 자체의 업무 영향:
- 전환 결정 시각 / 승인·위임 권한:
- 중단·재개 조건:
- 다음 공유 / 임시 조치 만료·검토 시각:
이번 변경의 체크리스트
작업을 따라가며 표시하세요. 완료율은 진행 기록일 뿐, 품질 보증이나 배포 승인이 아닙니다.개발 전
배포 전
배포 후
체크 상태는 이 브라우저에만 저장됩니다. 네트워크 전송은 없습니다. 로컬 파일의 저장 동작은 브라우저·보안 설정에 따라 다를 수 있으므로 중요한 기록은 내보내세요.
요청을 받으면 작업카드를 쓰고, 바꾸기 전 기준 실행을 남기고, 같은 평가로 후보를 비교한 뒤, 회귀와 복구 계획을 붙여 배포 판단을 요청합니다. 이후 운영 실패를 다음 평가에 넣습니다.
근거는 확인하고, 적용은 구분합니다.
아래 14개 1차 자료에서 해당 문장과 문맥을 확인했습니다. 공식 가이드·제품 문서·개발 방법론·실무자 해설은 근거의 성격이 서로 다릅니다. 일정·폴더 구성·보고 문구·가상 수치는 이를 적용한 제안입니다.
주장별 근거 지도 — 어떤 주장을 어디까지 뒷받침하나요?
근거 링크를 누르면 해당 인용 상자로 이동합니다. 번호는 아래 출처 목록과 연결됩니다.
| 플레이북의 주장 | 확인한 근거 | 넘겨짚지 말아야 할 것 |
|---|---|---|
| 개발 전 평가 목표 | [1] 평가를 초반부터 반복 | 개선 효과나 표본 수의 보증이 아님 |
| 일정·범위 협의 | [14] 수행자의 산정과 완료 기준 | 달력 일정의 단독 확정이 아님 |
| 마감이 고정된 요청 | [13] 시간 예산에 맞춘 범위 조정 | 모든 팀의 운영 방식은 아님 |
| AS-IS·TO-BE 보관 | [4] 실행별 버전·지표·원출력 추적 | 외부 모델 완전 재현의 보증이 아님 |
| 평가셋·회귀 확인 | [2] 새 능력과 기존 능력 보존의 구분 | 20~50건의 품질 보증이 아님 |
| RAG 원인 진단 | [5] 검색 과정과 최종 답변의 분리 | 한 지표로 업무 성공을 증명하지 않음 |
| 사용자 중심 보고 | [9] 사용자 가치에서 측정 지표 도출 | 가상 수치·합격선의 출처가 아님 |
| 배포·안전·복구 | [6] 반복 가능한 릴리스 과정 | 체크 표시가 배포 승인을 대신하지 않음 |
| 노출 확대와 효과 검증 | [7] 카나리 평가 후 확대·중단 판단 | 배포 자체로 사업 인과효과를 입증하지 않음 |
| 배포 후 운영·학습 | [3] 모니터링·피드백까지 생애주기에 포함 | 단순 전후 변화가 인과효과라는 뜻은 아님 |
| 피해의 심각도와 업무 우선순위를 구분합니다. | [15] [16] 적용 위치 → | 네 경로는 실무 제안이며 조직별 SEV 기준을 대체하지 않음 |
| 진행 중 피해는 차단·완화부터 시작하고 기록을 남깁니다. | [17] [18] 적용 위치 → | 증거 수집이 차단을 지연시켜서는 안 되며 무기록 변경도 피함 |
| 긴급 가속은 조건·권한·후속 검증을 갖춘 절차입니다. | [19] 적용 위치 → | 납기 압박 자체가 긴급 승인이나 안전 검증 면제는 아님 |
| 시한부 위험은 외부 종료 일정과 실제 작동 조건을 확인합니다. | [15] [21] 적용 위치 → | 역산 공수·시각은 예시이며 모든 의존성의 복구 가능성을 보장하지 않음 |
| 작은 수정도 관련 검사를 남기되 검증 계층을 구분합니다. | [22] [23] 적용 위치 → | 테스트의 형태를 구분하는 것이며 관련 검사를 생략하는 근거는 아님 |
| 반복되는 긴급 대응은 안정화 우선순위 논의의 근거입니다. | [20] 적용 위치 → | 공개된 예시 정책의 숫자를 모든 팀에 적용하지 않음 |
업무별 평가를 개발 초반부터 반복하고, 실제 사용 사례·사람 검토·지속 평가를 연결하는 원칙.
이 근거가 쓰인 본문으로 이동 →능력 평가와 회귀 평가의 구분, task·trial·실행 상태 평가, 실제 실패에서 작은 평가셋을 시작하는 방법.
이 근거가 쓰인 본문으로 이동 →개발·시험·개선의 내부 순환과 운영 배포·관리의 외부 순환, 모니터링과 피드백의 연결.
이 근거가 쓰인 본문으로 이동 →실행(run)별 파라미터·코드 버전·지표·출력 파일을 남기는 추적 모델. 특정 도구 도입은 선택.
이 근거가 쓰인 본문으로 이동 →RAG의 검색 과정과 최종 답변을 구분하는 평가 구조. 해당 제품의 지표는 예시로 읽음.
이 근거가 쓰인 본문으로 이동 →소스·빌드·설정·시험·배포를 의도적이고 반복 가능한 과정으로 만드는 릴리스 원칙.
이 근거가 쓰인 본문으로 이동 →한정된 범위·기간의 신규 배포를 평가하여 확대·중단 여부를 판단하는 카나리 운영 원칙.
이 근거가 쓰인 본문으로 이동 →카나리의 회귀 감지와 A/B 실험의 가설 검증이라는 목적 차이를 설명한 Danilo Sato의 글.
이 근거가 쓰인 본문으로 이동 →사용자가 중요하게 여기는 결과에서 지표와 목표를 정하고 측정 조건을 명시하는 운영 지침.
이 근거가 쓰인 본문으로 이동 →중요 장애의 영향·기여 원인·재발 방지 조치를 남기는 비난 없는 회고의 목적과 시행 조건.
이 근거가 쓰인 본문으로 이동 →Agent Builder의 MCP 도구 승인과 여러 방어 계층. 특정 제품 맥락을 밝혀 일반 안전 설계에 참고.
이 근거가 쓰인 본문으로 이동 →대응 표본을 같은 인덱스로 재표집하는 paired 옵션. 표본 설계와 군집 구조의 자동 해결책은 아님.
이 근거가 쓰인 본문으로 이동 →마감·시간 예산과 추정을 구분하고 범위를 조정하는 Basecamp의 개발 방법론. 업계 전체 표준은 아님.
이 근거가 쓰인 본문으로 이동 →실제 수행자의 작업 규모 산정 책임, 완료 기준·투입 가능 역량·작은 작업 단위에 근거한 계획.
이 근거가 쓰인 본문으로 이동 →업무 영향과 긴급도를 구분하고, 모든 사건을 같은 긴급도로 취급하지 않는 우선순위 원칙.
본문의 적용 위치로 돌아가기 →심각도는 영향, 우선순위는 처리의 긴급성과 순서를 나타낸다는 구분. SEV 등급은 조직별로 다름.
본문의 적용 위치로 돌아가기 →진행 중 장애의 영향 완화와 원인 분석을 구분하고, 대응·소통·지휘를 조율하는 원칙.
본문의 적용 위치로 돌아가기 →피해 완화·서비스 복구·증거 보존, 단일 대응 체계와 실시간 사건 기록·인계.
본문의 적용 위치로 돌아가기 →평시·긴급 변경을 같은 위험 관리 체계 안에서 다룸. 긴급 가속의 조건·승인자와 별도 검증을 명시.
본문의 적용 위치로 돌아가기 →안정성이 나빠졌을 때 기능 변경을 제한하되 중요 복구·보안 수정은 구분하는 예시 정책.
본문의 적용 위치로 돌아가기 →모델·API 종료와 대체 경로를 확인하는 원문. 실제 사용 서비스의 종료 공지는 별도 확인해야 함.
본문의 적용 위치로 돌아가기 →작동하는 코드와 이를 유지하는 테스트를 함께 남기는 관점. 버그를 드러내는 테스트를 회귀 자산으로 활용.
본문의 적용 위치로 돌아가기 →다양한 테스트 계층을 균형 있게 사용하고, 좁고 빠른 테스트와 넓은 검증의 역할을 구분하는 관점.
본문의 적용 위치로 돌아가기 →신뢰성을 읽는 세 가지 기준
원문과 적용을 구분합니다. 인용 상자의 영어는 원문에서 짧게 발췌했고 한국어는 비공식 번역입니다. 작업카드·필드·일정표·배포 게이트는 이 문서가 재구성한 제안입니다.
가이드와 실증 결과를 구분합니다. 좋은 관행에 대한 출처가 있다고 해서 특정 회사에서 일정이 단축되거나 정확도가 개선됐다는 실험 결과가 되는 것은 아닙니다. 개선 효과는 해당 서비스의 동일 조건 평가로 별도 확인해야 합니다.
적용 범위를 확인합니다. Scrum·Shape Up은 개발 방법론, MLflow·SciPy는 도구 문서, Agent Builder 안전 지침은 제품별 가이드입니다. 여기서는 필요한 원칙을 인용했으며, 모든 회사의 공통 의무 절차나 특정 제품 도입을 주장하지 않습니다.
위험별 대응 보완의 범위: 기존 출처·인용을 유지하고 [15]–[23]을 추가했습니다. 네 가지 대응 경로, 가상 시나리오, 역산 일정, 예외 카드와 체크리스트는 공식 자료를 바탕으로 만든 실무 제안입니다. 조직별 SEV·승인·보안 규정의 대체물이 아닙니다.
20~50건이면 품질이 보장된다는 주장, 오류 0건이면 안전하다는 주장, 통계적으로 유의하지 않으면 동등하다는 주장, 카나리만 하면 사용자 성과가 개선됐다는 주장, 기록만 있으면 외부 모델까지 언제든 완전히 재현할 수 있다는 주장은 하지 않습니다.
자료 확인: 2026-09-19. 링크의 API·제품명·지원 상태는 변경될 수 있습니다. 이 문서는 특정 평가 플랫폼 사용법이 아니라 서비스 개발의 판단·기록 구조에 초점을 둡니다. 외부 자료는 원문 링크를 눌러 확인할 수 있습니다.
'관심있는 주제 > 탐구 노트' 카테고리의 다른 글
| 토스증권 AI 백엔드 사례로 배우는 LLM API 설계와 운영 (0) | 2026.10.02 |
|---|---|
| LLM Wiki가 커질 때 어떻게 운영할까: 3만 문서·100만 링크에서 배운 확장 전략 (0) | 2026.09.23 |
| MCP는 AI용 함수 호출을 넘어 어디로 가는가: Python 개발자가 알아야 할 2026 로드맵 (0) | 2026.08.24 |
| DDD를 공부하다 FDE가 떠올랐다: FDE는 한국의 SI 개발자와 무엇이 다른가 (0) | 2026.08.23 |
| 그래픽 웹 × AI 에이전트 웹: HTML-in-Canvas와 WebMCP가 바꾸는 웹의 미래 (0) | 2026.08.22 |